June | 2026
Meta had contractors pose as minors to test how rival chatbots handled some of the most dangerous subjects a child might bring to a screen. According to WIRED, workers on a project managed by Covalen created dummy under-18 accounts and sent prompts to ChatGPT, Gemini, and Character.AI about suicide, eating disorders, sex, drugs, and other high-risk material. One testing round in 2025 produced tens of thousands of prompts. Meta defended the work as routine safety benchmarking and said it does not use competitor benchmarking to train its own models. The companies being tested said they had not authorized the project.
The detail that stays with the story is the borrowed child. An adult worker writes panic, shame, danger, curiosity, and bad advice into a rival system while a spreadsheet waits for the answer. The exercise may produce useful evidence about refusal rules, but it also turns adolescent distress into a competitive instrument. Safety work needs ugly examples, because real harm often arrives in ugly language. The trouble begins when the child in crisis becomes a role performed at scale by contractors, inside dummy accounts, for a company trying to measure competitors without being seen. The teenager is absent, but the job still requires someone to manufacture the sentence a frightened teenager might type alone.
Meta hizo que contratistas se hicieran pasar por menores para probar cómo respondían chatbots rivales ante algunos de los temas más peligrosos que un niño podría llevar a una pantalla. Según WIRED, trabajadores de un proyecto gestionado por Covalen crearon cuentas falsas de menores de 18 años y enviaron prompts a ChatGPT, Gemini y Character.AI sobre suicidio, trastornos alimentarios, sexo, drogas y otros materiales de alto riesgo. Una ronda de pruebas en 2025 produjo decenas de miles de prompts. Meta defendió el trabajo como una práctica rutinaria de evaluación de seguridad y dijo que no usa comparaciones con competidores para entrenar sus propios modelos. Las empresas evaluadas dijeron que no habían autorizado el proyecto.
El detalle que queda de la historia es el niño prestado. Un trabajador adulto escribe pánico, vergüenza, peligro, curiosidad y malos consejos dentro de un sistema rival mientras una hoja de cálculo espera la respuesta. El ejercicio puede producir evidencia útil sobre reglas de rechazo, pero también convierte la angustia adolescente en instrumento competitivo. El trabajo de seguridad necesita ejemplos feos, porque el daño real suele llegar en lenguaje feo. El problema empieza cuando el niño en crisis se vuelve un papel interpretado a escala por contratistas, dentro de cuentas falsas, para una empresa que intenta medir a sus competidores sin ser vista. El adolescente está ausente, pero el trabajo todavía exige que alguien fabrique la frase que un adolescente asustado podría escribir a solas.
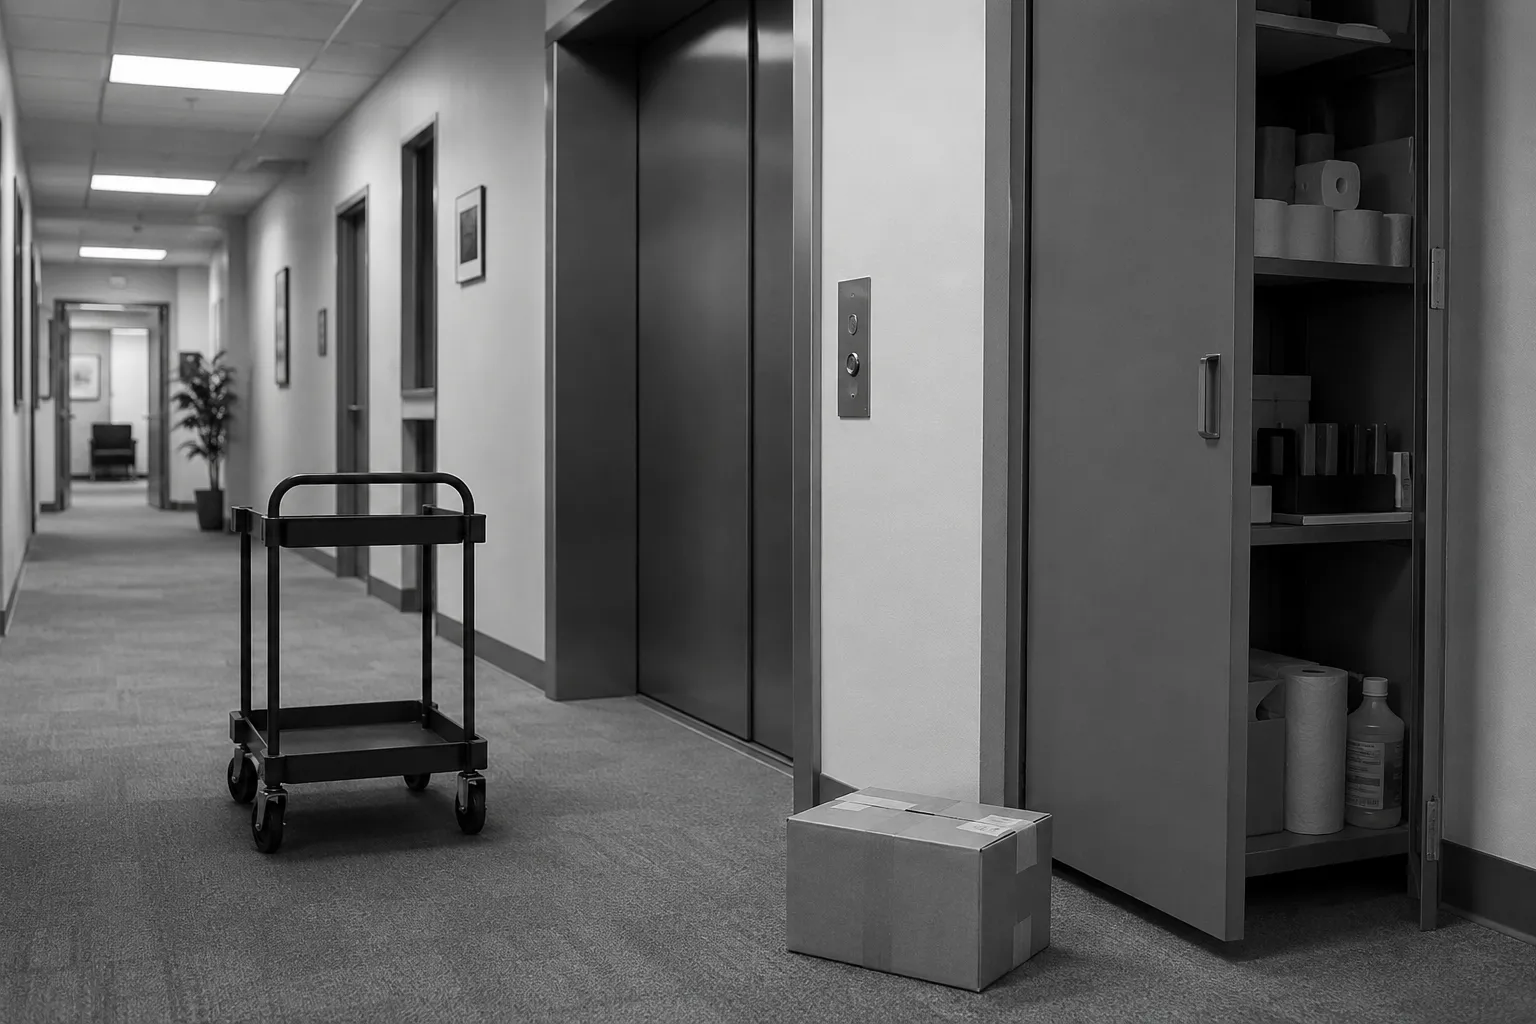
Flexion Robotics showed WIRED a humanoid robot carrying out an office errand usually hidden at the bottom of a job description. A modified Unitree machine receives a simple instruction, picks up a delivered parcel, takes stairs and an elevator, opens the box, and puts snacks in a drawer. The Swiss startup, founded by former Nvidia robotics researchers, says it trains individual skills in simulation and lets a higher-level model decide how to combine them. There is no operator steering the limbs from behind a console. The robot reads a goal, selects learned actions, and carries the task through an ordinary building.
The scene works because office labor is full of small physical negotiations that people stop noticing after a week in the building. A door resists, an elevator arrives late, a drawer jams, a package slides, a shelf sits too high, and a hallway demands the etiquette of waiting, holding, yielding, carrying. Flexion is training the robot for this minor grammar of work, where automation has less to do with heroic intelligence than with keeping the workplace moving through its errands. Companies prefer to describe such systems as productivity. The office runs on setup, fetching, sorting, opening, correcting, and waiting for someone else to finish. The intern enters a meeting room to learn strategy, then becomes the body sent to find the box, press the button, keep the door from closing, and make the place continue without naming the labor that holds it together.
Flexion Robotics mostró a WIRED un robot humanoide ejecutando un encargo de oficina de esos que suelen quedar escondidos al final de una descripción de puesto. Una máquina Unitree modificada recibe una instrucción simple, recoge un paquete entregado, toma escaleras y ascensor, abre la caja y coloca snacks en un cajón. La startup suiza, fundada por antiguos investigadores de robótica de Nvidia, dice que entrena habilidades individuales en simulación y deja que un modelo superior decida cómo combinarlas. No hay un operador dirigiendo las extremidades desde una consola. El robot lee una meta, selecciona acciones aprendidas y completa la tarea dentro de un edificio común.
La escena funciona porque el trabajo de oficina está lleno de pequeñas negociaciones físicas que la gente deja de notar después de una semana en el edificio. Una puerta resiste, un ascensor tarda, un cajón se traba, un paquete resbala, un estante queda demasiado alto y un pasillo exige la etiqueta de esperar, sostener, ceder, cargar. Flexion entrena al robot para esa gramática menor del trabajo, donde la automatización tiene menos relación con la inteligencia heroica que con mantener la oficina en movimiento a través de sus recados. Las compañías prefieren describir estos sistemas como productividad. La oficina funciona con preparación, búsqueda, clasificación, apertura, corrección y espera de que alguien más termine. El becario entra a una sala de reuniones para aprender estrategia y luego se convierte en el cuerpo enviado a buscar la caja, apretar el botón, impedir que se cierre la puerta y hacer que el lugar siga funcionando sin nombrar el trabajo que lo sostiene.
Prosecutors in the Palisades fire trial brought ChatGPT logs into court alongside iPhone location data, security camera footage, and witness testimony. Jonathan Rinderknecht was accused of starting a January 2025 blaze that later became one of the deadliest wildfires in Los Angeles history. According to The Verge, the prosecution cited chatbot exchanges in which he generated images of fire, asked why he felt angry, complained about the wealthy, and recorded a question about whether someone could be blamed if a cigarette started a fire. The jury did not accept the theory. After a 10-2 vote favoring the defense, the judge declared a mistrial.
The juror who spoke afterward gave the case its sharper edge. She said she talks to ChatGPT all the time and became angry at the suggestion that using a chatbot showed a character flaw. That reaction marks a limit prosecutors will keep meeting as private AI use becomes ordinary. A search history can look incriminating because it points to an action already known to have happened. A chatbot record is messier. It can contain fantasy, rehearsal, confession, curiosity, venting, boredom, or a sentence typed because the interface was available at a bad hour. The courtroom now has to decide when a prompt is evidence and when it is only a person speaking into software that answers back.
Los fiscales del juicio por el incendio de Palisades llevaron registros de ChatGPT al tribunal junto con datos de ubicación del iPhone, videos de cámaras de seguridad y testimonios. Jonathan Rinderknecht fue acusado de iniciar un fuego en enero de 2025 que luego se convirtió en uno de los incendios más mortales en la historia de Los Ángeles. Según The Verge, la fiscalía citó intercambios con el chatbot en los que generó imágenes de fuego, preguntó por qué se sentía tan enojado, se quejó de los ricos y grabó una consulta sobre si alguien podía ser culpado cuando un cigarrillo originaba un incendio. El jurado no aceptó la teoría. Tras una votación de 10 a 2 a favor de la defensa, la jueza declaró juicio nulo.
La jurado que habló después le dio al caso su filo más preciso. Dijo que usa ChatGPT todo el tiempo y que le molestó la insinuación de que hablar con un chatbot mostrara una falla de carácter. Esa reacción marca un límite que los fiscales seguirán encontrando a medida que el uso privado de IA se vuelva común. Un historial de búsqueda puede parecer incriminatorio porque apunta hacia una acción que ya se sabe ocurrida. Un registro de chatbot es más desordenado. Puede contener fantasía, ensayo, confesión, curiosidad, desahogo, aburrimiento o una frase escrita porque la interfaz estaba disponible en una mala hora. El tribunal ahora tiene que decidir cuándo un prompt es evidencia y cuándo es solo una persona hablándole a un software que responde.
At the Babell Literary and Cultural Festival in Porto, Margaret Atwood described a small failure with a familiar shape. She had asked Claude for information about the British detective series Father Brown, according to Deadline and The Verge, and the chatbot gave her the wrong answer. Atwood traced the mistake to the material the system had likely absorbed. Reviews often discuss detective stories while protecting the ending, so Claude had learned from summaries shaped by courtesy and suspense. It returned certainty from sources built around withholding. Atwood first called the answer a lie, then narrowed the accusation. A language model has no intention. It predicts from traces left by other texts.
The error came from culture as much as from software. Spoiler etiquette, promotional writing, cautious criticism, and recycled summaries all leave gaps. A model trained on that archive can fill the gap with clean prose and no visible warning. The same habit follows it into offices, schools, journalism, and business research, where a fluent answer can hide the missing page. Atwood's test was minor, almost comic, but it points to the labor AI keeps handing back to the user. Check the episode, open the book, find the record, ask the person who actually knows what happened.
En el Babell Literary and Cultural Festival de Oporto, Margaret Atwood describió una pequeña falla de forma conocida. Había pedido a Claude información sobre la serie detectivesca británica Father Brown, según Deadline y The Verge, y el chatbot le dio una respuesta equivocada. Atwood rastreó el error hasta el material que el sistema probablemente había absorbido. Las reseñas suelen comentar historias policiales mientras protegen el desenlace, así que Claude había aprendido de resúmenes marcados por la cortesía y el suspenso. Devolvió certeza a partir de fuentes construidas alrededor de lo que se calla. Atwood primero llamó mentira a la respuesta y luego afinó la acusación. Un modelo de lenguaje carece de intención. Predice desde rastros dejados por otros textos.
El error venía de la cultura tanto como del software. La etiqueta del spoiler, la escritura promocional, la crítica cautelosa y los resúmenes reciclados dejan huecos. Un modelo entrenado sobre ese archivo puede llenar el hueco con prosa limpia y sin advertencia visible. El mismo hábito lo acompaña en oficinas, escuelas, periodismo e investigación empresarial, donde una respuesta fluida puede esconder la página que falta. La prueba de Atwood fue menor, casi cómica, pero señala el trabajo que la IA sigue devolviendo al usuario. Revisar el episodio, abrir el libro, buscar el registro, preguntar a la persona que realmente sabe qué ocurrió.
The phone alerts many Venezuelans saw before this week's earthquakes were not a glimpse of the future. They were the result of Google's Android Earthquake Alerts System, which turns phones into a distributed seismic network. Outside parts of the United States that use ShakeAlert, Android phones can use their accelerometers to detect motion that may indicate an earthquake. When enough phones near the source send similar signals with coarse locations, Google's server estimates what is happening and sends alerts to users who may feel shaking. The warning can arrive first because electronic messages travel faster than the damaging seismic waves moving through the ground.
The social fact is sharper than the technology. In countries without dense public warning infrastructure, a private phone network can become the first alarm of a national disaster. That may save seconds, and seconds can be enough to move away from glass, leave a staircase, or drop and cover before stronger motion arrives. It also means that an emergency function once associated with the state now depends on operating systems, device settings, network coverage, battery charge, and a company server. The alert on the screen is small, but behind it sits a new form of public safety built from private sensors in millions of pockets.
Las alertas que muchos venezolanos vieron en sus teléfonos antes de los terremotos de esta semana no fueron una mirada al futuro. Fueron resultado del Android Earthquake Alerts System de Google, que convierte teléfonos en una red sísmica distribuida. Fuera de las zonas de Estados Unidos que usan ShakeAlert, los teléfonos Android pueden usar sus acelerómetros para detectar movimientos que podrían indicar un sismo. Cuando suficientes teléfonos cerca del origen envían señales parecidas con ubicaciones aproximadas, el servidor de Google estima lo que ocurre y manda alertas a usuarios que podrían sentir el temblor. El aviso puede llegar primero porque los mensajes electrónicos viajan más rápido que las ondas sísmicas dañinas que avanzan por el suelo.
El hecho social es más agudo que la tecnología. En países sin una infraestructura pública densa de alerta temprana, una red privada de teléfonos puede convertirse en la primera alarma de un desastre nacional. Eso puede ganar segundos, y unos segundos pueden bastar para alejarse de un vidrio, salir de una escalera o agacharse y cubrirse antes de que llegue el movimiento más fuerte. También significa que una función de emergencia antes asociada al Estado depende ahora de sistemas operativos, ajustes del dispositivo, cobertura de red, batería y un servidor corporativo. La alerta en la pantalla es pequeña, pero detrás de ella aparece una nueva forma de seguridad pública hecha con sensores privados en millones de bolsillos.
The AI data center boom is showing up in the price of ordinary machines. Apple raised prices across MacBooks, iPads, the HomePod, Apple TV, and Vision Pro after saying component costs had reached a scale it had never seen. The MacBook Neo now starts at $699 instead of $599, and some high-end Macs rose by hundreds or even more. Microsoft has cut RAM in cheaper Surface models, Xbox console prices have climbed by $100 or more, and Valve's Steam Machine starts at $1,049. The pressure comes from memory and storage shortages as AI companies and hyperscalers buy huge quantities of RAM and SSDs for model training, inference, and data centers.
The useful part of this story is that AI infrastructure stops being invisible when it changes a price tag. A student buying a laptop, a family replacing a tablet, or a player looking at a console is now competing with server farms that can pay more for the same components. The industry sells AI as software, but its physical appetite reaches into supply chains for chips, memory, storage, power, cooling, land, and water. The extra cost does not appear as an AI subscription. It appears as a worse base model, less RAM, a delayed purchase, or a computer that simply stays on the shelf.
El auge de los centros de datos de IA ya aparece en el precio de las máquinas comunes. Apple subió precios en MacBooks, iPads, HomePod, Apple TV y Vision Pro después de decir que los costos de componentes llegaron a una escala que nunca había visto. La MacBook Neo ahora empieza en 699 dólares en vez de 599, y algunas Macs de gama alta subieron cientos de dólares o incluso más. Microsoft redujo la RAM en modelos Surface más baratos, las consolas Xbox aumentaron 100 dólares o más, y la Steam Machine de Valve empieza en 1,049 dólares. La presión viene de la escasez de memoria y almacenamiento, mientras empresas de IA e hyperscalers compran enormes cantidades de RAM y SSDs para entrenamiento, inferencia y centros de datos.
La parte útil de esta historia es que la infraestructura de IA deja de ser invisible cuando cambia una etiqueta de precio. Un estudiante que compra una laptop, una familia que reemplaza una tableta o un jugador que mira una consola compite ahora con granjas de servidores capaces de pagar más por los mismos componentes. La industria vende la IA como software, pero su apetito físico entra en cadenas de suministro de chips, memoria, almacenamiento, energía, enfriamiento, tierra y agua. El costo extra no aparece como una suscripción de IA. Aparece como un modelo base peor, menos RAM, una compra aplazada o una computadora que simplemente se queda en el estante.
Corporate AI money has turned a Manhattan congressional primary into a test site for the industry's political future. According to The Verge, super PACs tied to AI interests have spent about $27.83 million around the NY-12 race, much of it connected to state Assemblyman Alex Bores, who helped pass an AI safety law in New York. Some money has come from safety-aligned groups linked to Anthropic supporters. Other money has come from anti-regulation or rival tech interests. A crypto billionaire connected to Ripple has also entered the fight. The candidate himself did not set out to make AI safety the center of the campaign, but outside money has made the seat into a proxy contest.
The useful fact is the scale. AI companies are trying to shape the political field before most voters have a clear language for the policy fight. Super PACs cannot coordinate with campaigns, but they can buy ads, produce content, define enemies, and make a local race feel like a national referendum. Residents may still be thinking about rent, transit, Israel, Trump, or the direction of the Democratic Party. The industry is thinking about future committee votes, liability rules, model restrictions, data centers, and who will be friendly when regulation reaches Congress. The ballot remains local. The invoice already belongs to the AI economy.
El dinero corporativo de la IA convirtió una primaria congresional de Manhattan en un campo de prueba para el futuro político de la industria. Según The Verge, super PACs vinculados a intereses de IA han gastado cerca de 27.83 millones de dólares alrededor de la carrera por NY-12, buena parte de ellos relacionados con el asambleísta estatal Alex Bores, quien ayudó a aprobar una ley de seguridad de IA en Nueva York. Parte del dinero viene de grupos favorables a la seguridad vinculados a simpatizantes de Anthropic. Otra parte viene de intereses tecnológicos rivales o contrarios a la regulación. Un multimillonario cripto conectado con Ripple también entró en la disputa. El propio candidato no había planeado poner la seguridad de IA en el centro de la campaña, pero el dinero externo convirtió el escaño en una contienda por poder delegado.
El dato útil es la escala. Las empresas de IA intentan moldear el terreno político antes de que la mayoría de los votantes tenga un lenguaje claro para esa disputa regulatoria. Los super PACs no pueden coordinarse con las campañas, pero pueden comprar anuncios, producir contenido, definir enemigos y hacer que una carrera local parezca un referendo nacional. Los residentes quizá siguen pensando en renta, transporte, Israel, Trump o el rumbo del Partido Demócrata. La industria piensa en futuros votos de comité, reglas de responsabilidad, límites para modelos, centros de datos y quién será amistoso cuando la regulación llegue al Congreso. La boleta sigue siendo local. La factura ya pertenece a la economía de la IA.
Meta's Oversight Board has ordered Instagram to remove a reportedly AI-generated sexualized video impersonating a woman who is not a public figure. The eight-second post was flagged by Meta's automated systems, reported by two users, and appealed by one of them, but it remained online. Meta later argued that it lacked a clear signal that the woman depicted was real or that she had not consented, partly because she had not reported the post herself. The Board rejected that standard. It said the content violated Meta's rules on non-consensual intimate imagery and recommended that AI-generated sexualized impersonation of real people be treated as non-consensual by default.
The decision moves the burden away from the target of the abuse. A person whose face or body has been simulated may learn about the post after copies have traveled through accounts, messages, screenshots, and search results. Requiring that person to prove harm first gives the platform time while the image keeps circulating. The Board wants Meta to let trusted friends or family report on someone's behalf and to create a separate reporting category for AI-generated sexualized impersonation. A synthetic body can still damage a real person, and the first useful response is removal before the victim is forced to become the evidence clerk for her own violation.
El Oversight Board de Meta ordenó a Instagram retirar un video sexualizado, presuntamente generado con IA, que imitaba a una mujer que no es una figura pública. La publicación de ocho segundos fue detectada por sistemas automáticos de Meta, reportada por dos usuarios y apelada por uno de ellos, pero siguió en línea. Meta sostuvo después que no tenía una señal clara de que la mujer representada fuera una persona real o de que no hubiera dado consentimiento, en parte porque ella misma no había reportado la publicación. El Board rechazó ese estándar. Dijo que el contenido violaba las reglas de Meta sobre imágenes íntimas no consentidas y recomendó tratar la imitación sexualizada de personas reales generada con IA como no consentida por defecto.
La decisión desplaza la carga fuera de la persona afectada. Quien ve su rostro o su cuerpo simulado puede enterarse de la publicación después de que las copias circularon por cuentas, mensajes, capturas de pantalla y resultados de búsqueda. Exigir que esa persona pruebe primero el daño le da tiempo a la plataforma mientras la imagen sigue moviéndose. El Board quiere que Meta permita a amistades o familiares de confianza reportar en nombre de alguien y que cree una categoría separada para denunciar imitaciones sexualizadas generadas con IA. Un cuerpo sintético puede dañar a una persona real, y la primera respuesta útil es retirarlo antes de obligar a la víctima a convertirse en oficinista probatoria de su propia violación.
AI coding tools are making it easy for people to build apps before they understand what those apps can expose. The latest concern is vibe coding, the practice of describing a product in natural language and letting an AI system write much of the code. That can help a student, worker, founder, or hobbyist build useful software in hours. It can also put a public database, a customer record, a medical note, a private message, or a payment field online without the builder recognizing the risk. Recent examples include hidden SQL injection flaws, production databases left open, and thousands of public apps with weak or missing authentication.
The social change is simple. Software creation is no longer limited to people trained to think about failure. That is good for experimentation, but it moves responsibility faster than knowledge. A private tool becomes a public service the moment it stores someone else's data or runs in the cloud. Security cannot remain an expert ritual added after launch. The person who asks a model to build an app must also ask what the app stores, who can enter, what happens if it leaks, and whether a human needs to review it before strangers use it.
Las herramientas de programación con IA están facilitando que muchas personas construyan apps antes de entender qué pueden exponer esas apps. La preocupación más reciente es el vibe coding, la práctica de describir un producto en lenguaje natural y dejar que un sistema de IA escriba buena parte del código. Eso puede ayudar a un estudiante, trabajador, fundador o aficionado a crear software útil en horas. También puede poner en línea una base de datos pública, un registro de clientes, una nota médica, un mensaje privado o un campo de pago sin que quien construyó la app reconozca el riesgo. Ya hay ejemplos de fallas ocultas de SQL injection, bases de datos de producción abiertas y miles de apps públicas con autenticación débil o ausente.
El cambio social es simple. Crear software ya no está limitado a personas entrenadas para pensar en fallas. Eso favorece la experimentación, pero mueve la responsabilidad más rápido que el conocimiento. Una herramienta privada se vuelve un servicio público en el momento en que guarda datos de otra persona o funciona en la nube. La seguridad no puede seguir siendo un ritual experto añadido después del lanzamiento. Quien pide a un modelo que construya una app también debe preguntar qué guarda la app, quién puede entrar, qué ocurre si hay una filtración y si alguien con criterio técnico debe revisarla antes de que la usen desconocidos.
Millions of songs used in AI training datasets can now be searched by artist and title. The database includes large collections with roughly 12 million and 9 million tracks, plus two smaller sets with more than 100,000 songs each. Some of the material comes from public links to YouTube, Spotify, or music archives, but public access does not automatically mean permission for commercial training. The names reportedly found in the lists range from Lady Gaga and Radiohead to Aphex Twin, Wu-Tang Clan, Bruce Springsteen, and SZA, who said 238 of her songs appeared there.
The useful part of this case is that it makes a hidden supply chain visible. Musicians have been told for years that AI systems learn from vast amounts of culture, but that phrase keeps the damage abstract. A searchable database lets artists check whether their own work helped train a model, then ask who collected it, who downloaded it, and who benefits from the result. It also shows why consent becomes difficult once culture is treated as raw material at internet scale. A song can move from stream to dataset to model before its author knows it was part of the transaction.
Millones de canciones usadas en conjuntos de entrenamiento de IA ahora pueden buscarse por artista y título. La base incluye colecciones grandes con cerca de 12 millones y 9 millones de pistas, además de dos conjuntos menores con más de 100,000 canciones cada uno. Parte del material viene de enlaces públicos a YouTube, Spotify o archivos musicales, pero el acceso público no equivale automáticamente a permiso para entrenamiento comercial. Entre los nombres reportados aparecen Lady Gaga, Radiohead, Aphex Twin, Wu-Tang Clan, Bruce Springsteen y SZA, quien dijo que 238 de sus canciones estaban allí.
Lo útil del caso es que vuelve visible una cadena de suministro que suele permanecer oculta. Durante años se ha dicho a los músicos que los sistemas de IA aprenden de enormes cantidades de cultura, pero esa frase mantiene el daño en abstracto. Una base buscable permite a los artistas comprobar si su propia obra ayudó a entrenar un modelo y preguntar quién la recopiló, quién la descargó y quién se beneficia del resultado. También muestra por qué el consentimiento se vuelve difícil cuando la cultura se trata como materia prima a escala de internet. Una canción puede pasar de stream a dataset y de dataset a modelo antes de que su autor sepa que formó parte de la transacción.
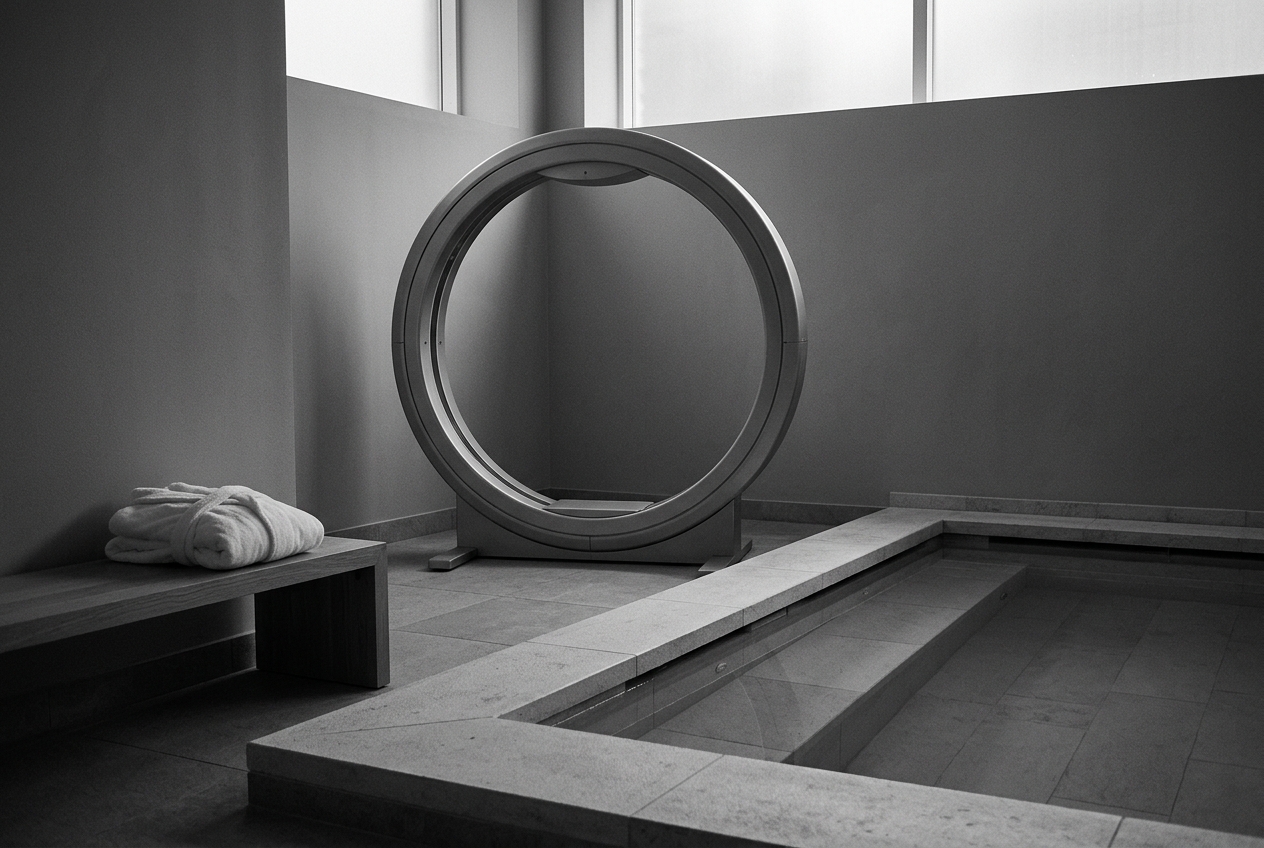
Midjourney has moved from synthetic pictures to the promise of scanning the body. Its new medical project is an ultrasound-based full-body scanner built with Butterfly Network, using a ring of sensors to capture vertical slices of muscle, fat, bone, and organs. David Holz described a 60-second scan that could be repeated yearly or even daily, first for body composition maps rather than formal diagnosis. The planned San Francisco site is framed as a spa, with water, saunas, cold plunges, and rooms where the visitor descends through sensors before receiving another image of the self.
The strange part is the continuity. Midjourney became famous by turning language into pictures people could desire, collect, correct, and display. The scanner brings that appetite inward. A body becomes a recurring visual file, a private archive that may be shared with doctors, health tools, or whatever platform learns to read it next. Medicine has always depended on images, but the spa setting changes the ritual. The scan is sold as prevention, measurement, and self-knowledge before illness has appeared. The user leaves with no diagnosis, perhaps, but with a new habit of being rendered from the inside.
Midjourney pasó de las imágenes sintéticas a la promesa de escanear el cuerpo. Su nuevo proyecto médico es un escáner corporal de ultrasonido desarrollado con Butterfly Network, con un aro de sensores que captura cortes verticales de músculo, grasa, huesos y órganos. David Holz describió una exploración de 60 segundos que podría repetirse cada año o incluso cada día, primero para mapas de composición corporal antes que para diagnóstico formal. El local previsto en San Francisco se presenta como un spa, con agua, saunas, baños fríos y salas donde el visitante desciende entre sensores antes de recibir otra imagen de sí mismo.
Lo extraño está en la continuidad. Midjourney se hizo famosa al convertir lenguaje en imágenes que la gente podía desear, coleccionar, corregir y mostrar. El escáner lleva ese apetito hacia dentro. Un cuerpo se vuelve un archivo visual recurrente, una colección privada que puede compartirse con médicos, herramientas de salud o la próxima plataforma que aprenda a leerla. La medicina siempre ha dependido de imágenes, pero el spa cambia el rito. La exploración se vende como prevención, medición y autoconocimiento antes de que aparezca la enfermedad. El usuario sale quizá sin diagnóstico, pero con un nuevo hábito de ser renderizado desde adentro.
AI is entering offices through the small work that used to make beginners useful. Readers writing to the Financial Times described translation checks, search tasks, email drafting, code review, legal preparation, administrative cleanup, and junior analysis being handed to systems before a new employee can practice them. The change does not always arrive as a firing notice. It appears as a missing assignment, a task no manager gives anymore, a first rung removed from the ladder while the job title remains in place.
The loss is practical before it becomes symbolic. A translator learned by correcting bad sentences. A developer learned by reading other people's errors. A lawyer learned by preparing documents that a partner later marked up. When those chores move to a model, the senior worker may become faster, but the beginner loses the slow contact with mistakes that builds judgment. Firms can treat the saved hours as productivity, yet someone still has to become competent enough to inspect the answer. The weakest point in an AI office may be the empty chair where apprenticeship used to sit.
La IA está entrando en las oficinas por el trabajo pequeño que antes volvía útiles a los principiantes. Lectores del Financial Times describieron revisiones de traducción, búsquedas, redacción de correos, revisión de código, preparación legal, limpieza administrativa y análisis junior entregados a sistemas antes de que un empleado nuevo pueda practicarlos. El cambio no siempre llega como un despido. Aparece como un encargo que falta, una tarea que ningún jefe asigna ya, un primer peldaño retirado de la escalera mientras el cargo sigue en pie.
La pérdida es práctica antes de volverse simbólica. Un traductor aprendía corrigiendo frases malas. Un desarrollador aprendía leyendo errores ajenos. Un abogado aprendía preparando documentos que después revisaba un socio. Cuando esas tareas pasan a un modelo, el trabajador senior puede avanzar más rápido, pero el principiante pierde el contacto lento con los errores que forma criterio. Las empresas pueden contabilizar las horas ahorradas como productividad, aunque alguien todavía debe volverse lo bastante competente para revisar la respuesta. El punto más débil de una oficina con IA puede ser la silla vacía donde antes se sentaba el aprendizaje.
The new argument over AI wealth begins with a tempting promise. If a few companies make enormous fortunes from models, chips, cloud contracts, and data centers, the public should receive a share. Trump has praised public stakes in AI companies. Sam Altman has floated versions of a shared-equity arrangement. Others imagine funds that would collect returns from the industry and send money to households. The proposal sounds fair because it gives citizens a visible claim on a boom built with public tolerance, public infrastructure, public energy grids, and public risk.
The difficulty starts once the state becomes a shareholder. A government that owns part of an AI company may hesitate before breaking it up, taxing it harder, slowing a risky model, or forcing expensive safety rules. A small dividend can turn into political cover for a large private empire. Taxation keeps the relationship clearer. If AI firms and their suppliers generate extraordinary rents, governments can tax profits, capital gains, energy demand, land use, and monopoly power without asking citizens to cheer for the stock price. The machine should pay for the burden it places on the public. A tax bill is cleaner than a share certificate.
El nuevo debate sobre la riqueza de la IA empieza con una promesa tentadora. Si unas pocas empresas hacen fortunas enormes con modelos, chips, contratos de nube y centros de datos, el público debería recibir una parte. Trump elogió participaciones públicas en empresas de IA. Sam Altman ha sugerido versiones de un arreglo con acciones compartidas. Otros imaginan fondos que recaudarían rendimientos de la industria y enviarían dinero a los hogares. La propuesta suena justa porque da a los ciudadanos un reclamo visible sobre un auge construido con tolerancia pública, infraestructura pública, redes eléctricas públicas y riesgo público.
La dificultad empieza cuando el Estado se vuelve accionista. Un gobierno que posee parte de una empresa de IA puede dudar antes de dividirla, gravarla con más fuerza, frenar un modelo riesgoso o imponer reglas de seguridad costosas. Un dividendo pequeño puede convertirse en cobertura política para un gran imperio privado. La vía fiscal mantiene más clara la relación. Si las empresas de IA y sus proveedores generan rentas extraordinarias, los gobiernos pueden gravar beneficios, ganancias de capital, demanda eléctrica, uso del suelo y poder monopólico sin pedir a los ciudadanos que celebren la cotización bursátil. La máquina debe pagar por la carga que pone sobre el público. Una factura fiscal es más limpia que un certificado de acciones.
Washington's order against Anthropic's Fable 5 and Mythos 5 has now produced its quieter aftershock. The first event was the veto itself, almost without precedent in commercial AI, with access cut for foreign nationals and the models removed for everyone. The next effect is commercial suspicion. A company outside the United States can look at the episode and see a model that may vanish after engineers have wired it into products, trained staff around it, signed contracts, and built plans on the assumption that access will remain open.
That is the useful opening for China. Its laboratories do not have to beat every American benchmark tomorrow if buyers begin to treat US models as politically fragile infrastructure. Availability becomes part of the product. Continuity becomes part of the sales pitch. Washington may believe it is keeping capability away from adversaries, yet foreign customers receive another lesson. The most advanced model in the room may also be the one its own government can remove fastest. The next procurement meeting will ask which system performs best, then which system is still likely to be there when the work starts.
La orden de Washington contra Fable 5 y Mythos 5 de Anthropic ya produjo su réplica más silenciosa. El primer hecho fue el veto mismo, casi sin precedentes en la IA comercial, con el acceso cortado para ciudadanos extranjeros y los modelos retirados para todos. El siguiente efecto es la sospecha comercial. Una empresa fuera de Estados Unidos puede mirar el episodio y ver un modelo capaz de desaparecer después de que sus ingenieros lo conectaron a productos, entrenaron personal alrededor de él, firmaron contratos y construyeron planes bajo la premisa de que el acceso seguiría abierto.
Ahí aparece la apertura útil para China. Sus laboratorios no tienen que superar mañana cada benchmark estadounidense si los compradores empiezan a tratar los modelos de Estados Unidos como infraestructura políticamente frágil. La disponibilidad se vuelve parte del producto. La continuidad se vuelve parte del argumento de venta. Washington puede creer que mantiene capacidades lejos de sus adversarios, pero los clientes extranjeros reciben otra lección. El modelo más avanzado de la sala puede ser también el que su propio gobierno retire más rápido. La próxima reunión de compras preguntará qué sistema rinde mejor y después cuál tiene más probabilidades de seguir ahí cuando empiece el trabajo.
The AI boom has begun to produce a political fantasy of public ownership. Donald Trump has praised the idea of AI companies contributing equity to a public wealth fund. Sam Altman has promoted versions of the same arrangement, and Bernie Sanders has called for a large one-time tax on AI firms paid in stock. Dario Amodei has spoken of universal capital accounts. The proposals differ, but they share one premise. If intelligence becomes a machine-owned source of extraordinary wealth, citizens may need a direct claim on the companies that own the machines.
The mechanism is less generous than the rhetoric. A few percentage points of equity in even the largest AI labs would not make households rich unless the companies grew into something close to planetary utilities. A broader levy on labs, chipmakers, cloud providers, and data-center firms would raise more money, but it would also force the state to define where the AI economy begins and ends. Public ownership creates another problem. A government that owns part of an AI firm may become more hesitant to regulate, break up, or punish it. The citizen is offered a small dividend, while the company receives a new argument for staying too important to disturb.
El auge de la IA empezó a producir una fantasía política de propiedad pública. Donald Trump elogió la idea de que las compañías de IA aporten acciones a un fondo de riqueza pública. Sam Altman ha promovido versiones del mismo arreglo, y Bernie Sanders pidió un gran impuesto único a las empresas de IA pagado en acciones. Dario Amodei habló de cuentas universales de capital. Las propuestas difieren, pero comparten una premisa. Si la inteligencia se convierte en una fuente de riqueza extraordinaria propiedad de máquinas y de quienes las controlan, los ciudadanos pueden necesitar un reclamo directo sobre esas compañías.
El mecanismo es menos generoso que la retórica. Unos pocos puntos porcentuales de participación en los mayores laboratorios de IA no volverían ricos a los hogares salvo que esas empresas crecieran hasta algo parecido a servicios públicos planetarios. Un gravamen más amplio sobre laboratorios, fabricantes de chips, proveedores de nube y centros de datos recaudaría más, pero también obligaría al estado a definir dónde empieza y termina la economía de IA. La propiedad pública crea otro problema. Un gobierno que posee parte de una empresa de IA puede volverse más reacio a regularla, dividirla o castigarla. Al ciudadano se le ofrece un dividendo pequeño, mientras la compañía recibe un nuevo argumento para seguir siendo demasiado importante como para molestarla.
Translation agencies are increasingly sending machine-produced drafts to freelancers and paying them to make the text usable. The assignment no longer begins with a sentence in one language and a blank space in another. It begins with an output that already sounds finished. The human translator is asked to check terminology, catch errors, repair tone, remove awkward phrasing, and accept responsibility for a version whose first decisions were made by software. Rates fall because the job is framed as correction, but the risk does not fall with them. A bad medical instruction, legal clause, technical manual, or literary sentence still carries a human name at delivery.
The surviving job sits in a narrower and more nervous position. Translators once moved between languages by weighing tone, context, idiom, silence, and the small betrayal every sentence requires. Now many receive a fluent surface that must be distrusted line by line. Fluency is the dangerous part, because bad language announces itself while smooth error passes as competence. Agencies save time by shifting uncertainty downward to freelancers paid to repair an output they did not author. The translator becomes a proofreader of automated confidence, responsible for the sentence after the machine has already made it sound inevitable.
Las agencias de traducción envían cada vez más borradores producidos por máquinas a freelancers y les pagan para volver utilizable el texto. El encargo ya no empieza con una frase en una lengua y un espacio vacío en otra. Empieza con una salida que ya parece terminada. Al traductor humano se le pide revisar terminología, detectar errores, reparar tono, quitar torpezas y aceptar responsabilidad por una versión cuyas primeras decisiones tomó un software. Las tarifas bajan porque el trabajo se presenta como corrección, pero el riesgo no baja con ellas. Una mala instrucción médica, una cláusula legal, un manual técnico o una frase literaria todavía lleva un nombre humano al entregarse.
El oficio que sobrevive ocupa una posición más estrecha y más nerviosa. Los traductores antes pasaban de una lengua a otra pesando tono, contexto, modismo, silencio y la pequeña traición que toda frase exige. Ahora muchos reciben una superficie fluida que deben desconfiar línea por línea. La fluidez es la parte peligrosa, porque el mal lenguaje se delata mientras el error terso pasa por competencia. Las agencias ahorran tiempo desplazando la incertidumbre hacia freelancers pagados para reparar una salida que no escribieron. El traductor se vuelve corrector de una confianza automática, responsable de la frase después de que la máquina ya la hizo sonar inevitable.
Meta has begun separating itself from Manus, the Chinese-founded agentic AI startup it agreed to buy for $2 billion, after Beijing ordered the transaction unwound on national security grounds. According to TechCrunch and Bloomberg, Meta has cut Manus off from internal systems, halted data sharing, and stopped employees from using its tools for company projects. Manus's founders have reportedly discussed raising about $1 billion to reclaim the company, possibly through a structure that keeps it closer to Chinese control and opens a path toward a Hong Kong listing.
The failed deal shows how AI acquisitions now pass through a sovereignty filter before they become corporate strategy. Meta wanted agent technology, investors wanted an exit, and Manus had already moved staff to Singapore. Beijing still treated the startup's origin, talent, data access, and technical direction as assets that could not simply be transferred to an American platform. The separation also follows tighter Chinese rules around foreign investment and travel permissions for AI researchers. Capital can cross borders quickly, but model builders, datasets, and internal tools now trigger state claims before the contract dries. For Meta, the missing asset is no longer a term sheet. It is a tool its own employees have been told to stop using.
Meta empezó a separarse de Manus, la startup de IA agéntica fundada en China que había acordado comprar por 2.000 millones de dólares, después de que Beijing ordenara deshacer la operación por motivos de seguridad nacional. Según TechCrunch y Bloomberg, Meta cortó el acceso de Manus a sus sistemas internos, detuvo el intercambio de datos y prohibió a sus empleados usar sus herramientas en proyectos de la compañía. Los fundadores de Manus habrían discutido levantar cerca de 1.000 millones de dólares para recuperar la empresa, posiblemente mediante una estructura que la mantenga más cerca del control chino y abra una vía hacia una salida a bolsa en Hong Kong.
El acuerdo fallido muestra cómo las compras de IA pasan ahora por un filtro de soberanía antes de convertirse en estrategia corporativa. Meta quería tecnología de agentes, los inversores querían una salida y Manus ya había trasladado personal a Singapur. Beijing aun así trató el origen de la startup, su talento, su acceso a datos y su dirección técnica como activos que no podían transferirse sin más a una plataforma estadounidense. La separación también llega tras reglas chinas más estrictas sobre inversión extranjera y permisos de viaje para investigadores de IA. El capital puede cruzar fronteras rápido, pero constructores de modelos, conjuntos de datos y herramientas internas activan reclamos estatales antes de que el contrato se seque. Para Meta, el activo ausente ya no es una hoja de términos. Es una herramienta que sus propios empleados recibieron orden de dejar de usar.
A Munich court has preliminarily ruled that Google can be held liable for false statements generated by AI Overviews, after two publishers said the search feature wrongly associated them with scams and questionable business practices. Google argued that the summaries were automated, that users were warned about possible errors, and that people should verify the information independently. The court took a harder view. It found that the disputed summaries created new, substantial statements that did not appear in the linked sources and that Google, as the company designing, training, operating, and managing the system, was the party able to prevent the damage.
The ruling moves liability from the linked page to the answer layer. A search engine used to defend itself as a directory of other people's statements. AI Overviews changes the operation by combining sources, compressing them, and presenting a generated sentence at the top of the page. If that sentence invents an accusation, the injured party cannot sue the original source, since the original source never said it. A warning label becomes thin protection when the falsehood arrives in the voice of the search interface itself. Google may appeal, but the case gives publishers, companies, and private people a procedural path toward the model operator, not the web pages it misread.
Un tribunal de Múnich resolvió de forma preliminar que Google puede ser responsable por declaraciones falsas generadas por AI Overviews, después de que dos editoriales afirmaran que el buscador las vinculó erróneamente con estafas y prácticas comerciales cuestionables. Google sostuvo que los resúmenes eran automáticos, que los usuarios recibían advertencias sobre posibles errores y que la información debía verificarse de manera independiente. El tribunal adoptó una lectura más severa. Consideró que los resúmenes discutidos crearon afirmaciones nuevas y sustanciales que no aparecían en las fuentes enlazadas, y que Google, como empresa que diseña, entrena, opera y gestiona el sistema, era la parte capaz de evitar el daño.
El fallo desplaza la responsabilidad desde la página enlazada hasta la capa de respuesta. Un buscador podía defenderse como directorio de declaraciones ajenas. AI Overviews cambia la operación al combinar fuentes, comprimirlas y presentar una frase generada en la parte superior de la página. Si esa frase inventa una acusación, la parte afectada no puede demandar a la fuente original, porque la fuente original nunca la dijo. Una advertencia se vuelve una protección débil cuando la falsedad llega con la voz de la propia interfaz de búsqueda. Google puede apelar, pero el caso ofrece a editoriales, empresas y personas una vía procesal hacia el operador del modelo, no hacia las páginas web que leyó mal.
The US government has ordered Anthropic to suspend access to Claude Fable 5 and Claude Mythos 5 for any foreign national, even those living inside the United States and even foreign employees of Anthropic itself. These were among the most powerful AI models ever shown to the public. Anthropic's response was to remove both models automatically for all users. The move is highly unusual, and in the public history of commercial AI releases, nearly without precedent. Fable 5 had just been released as Anthropic's most powerful widely available model, with safeguards around cybersecurity, biology, chemistry, and model distillation. Mythos 5 used the same underlying system with some safeguards lifted for trusted cyberdefenders.
The order exposes a strategic contradiction. Washington appears to be trying to keep the most capable American systems away from adversaries, yet the immediate effect is to remove an American model from the market. Anthropic says the government cited a possible way to bypass Fable's safety protections, but the company argues the example was of lesser importance, involved minor known vulnerabilities, and showed capabilities already available in other public models. AI is advancing at an exponential and vertiginous pace, which raises the chance that other countries may soon reveal models stronger than anything they have shown publicly so far, including Chinese systems developed outside American controls. If that happens while US models remain trapped behind emergency restrictions, the advantage shifts from technical superiority to commercial availability. Measures like this could even push frontier AI companies to ask whether remaining inside the United States has become a strategic liability. In AI, power belongs partly to whoever builds the strongest model, and partly to whoever can keep it usable.
El gobierno de Estados Unidos ordenó a Anthropic suspender el acceso a Claude Fable 5 y Claude Mythos 5 para cualquier ciudadano extranjero, incluso si vive dentro del país o trabaja para la propia Anthropic. Eran algunos de los modelos de inteligencia artificial más potentes mostrados hasta ahora al público. La respuesta de Anthropic fue retirarlos automáticamente para todos los usuarios. La medida es totalmente inusual y, en la historia pública de los lanzamientos comerciales de IA, casi no tiene precedentes. Fable 5 acababa de salir como el modelo más potente que Anthropic había puesto a disposición general, con protecciones en ciberseguridad, biología, química y destilación. Mythos 5 usaba el mismo sistema de base, pero con algunas protecciones levantadas para ciberdefensores de confianza.
La orden expone una contradicción estratégica. Washington parece intentar mantener los sistemas estadounidenses más capaces lejos de sus adversarios, pero el efecto inmediato es retirar del mercado un modelo estadounidense. Anthropic dice que el gobierno citó una posible forma de saltarse las protecciones de Fable, aunque la compañía sostiene que el ejemplo era de menor importancia, involucraba vulnerabilidades menores ya conocidas y mostraba capacidades disponibles en otros modelos públicos. La IA avanza a un ritmo exponencial y vertiginoso, lo que aumenta la posibilidad de que otros países revelen pronto modelos más fuertes que los mostrados hasta ahora, incluidos sistemas chinos fuera de los controles estadounidenses. Si eso ocurre mientras los modelos de Estados Unidos permanecen atrapados detrás de restricciones de emergencia, la ventaja se desplaza de la superioridad técnica a la disponibilidad comercial. Medidas así podrían incluso empujar a las compañías de IA de frontera a preguntarse si permanecer dentro de Estados Unidos se ha convertido en una desventaja estratégica.
A Florida man was arrested after police treated a face-recognition result as a lead strong enough to help carry a warrant. According to a lawsuit filed by the ACLU and reported by WIRED, Robert Dillon lived over 300 miles from the Jacksonville Beach McDonald's where a man had allegedly tried to lure a child. A police system called FACES returned a 93 percent facial match from a poor image taken off surveillance footage. That number measured similarity between images. It did not say the two faces belonged to the same person.
The damage came from the institution around the software. License plate searches reportedly placed Dillon's vehicles nowhere near the county, a restaurant manager said the suspect was a regular customer, and six months passed before the warrant was submitted. The arrest still happened. Dillon was taken from his home, spent a night in jail, pledged his truck title for bond, lost work during crab season, and watched his mug shot remain online after charges were dropped. The machine supplied a resemblance, then the paperwork gave it weight. In cases like this, the face becomes a shortcut through doubt, and the person has to spend months proving that a score was only a score.
Un hombre de Florida fue arrestado después de que la policía tratara un resultado de reconocimiento facial como una pista con fuerza suficiente para sostener una orden judicial. Según una demanda presentada por la ACLU y reportada por WIRED, Robert Dillon vivía a más de 300 millas del McDonald's de Jacksonville Beach donde un hombre habría intentado atraer a una niña. Un sistema policial llamado FACES devolvió una coincidencia facial del 93 por ciento a partir de una imagen deficiente tomada de una grabación de vigilancia. Ese número medía parecido entre imágenes. No decía que los dos rostros pertenecieran a la misma persona.
El daño vino de la institución que rodeó al software. Las búsquedas de matrículas habrían ubicado los vehículos de Dillon lejos del condado, una gerente del restaurante dijo que el sospechoso era un cliente habitual, y pasaron seis meses antes de que se presentara la orden. El arresto ocurrió de todos modos. Dillon fue sacado de su casa, pasó una noche en la cárcel, empeñó el título de su camioneta para pagar la fianza, perdió trabajo durante la temporada de cangrejo y vio su ficha policial en línea después de que retiraran los cargos. La máquina entregó un parecido, luego el expediente le dio peso. En casos así, el rostro se convierte en un atajo a través de la duda, y la persona debe pasar meses probando que una puntuación era solo una puntuación.
OpenAI is preparing a major redesign of ChatGPT that would move the product beyond the blank chat box and into a place where people do things. According to The Verge, which summarized reporting from the Financial Times, the company wants ChatGPT to handle coding, image creation, agents, and outside apps inside a broader interface. One senior OpenAI employee reportedly described the old chat format as dead. The phrase sounds dramatic, but the point is practical. OpenAI has built one of the most familiar interfaces on the internet, and now it needs that habit to produce steadier revenue as it moves toward a public listing.
The current chat box is easy to understand. A person types, the system replies, and the exchange feels almost free even when the computing cost is large. A redesigned ChatGPT would change that routine by placing more paid actions around the conversation. A request could become a coding session, a generated file, a booking, a workflow run by an agent, or a task completed through a partner app. The user may still begin with a sentence, but the product can guide that sentence toward services with prices, subscriptions, limits, and commissions. OpenAI is polishing the interface while trying to turn ChatGPT from a habit people visit into a business people pay through.
OpenAI prepara un rediseño importante de ChatGPT para sacar el producto de la caja vacía de conversación y llevarlo a un lugar donde la gente hace cosas. Según The Verge, que resumió información del Financial Times, la compañía quiere que ChatGPT integre programación, creación de imágenes, agentes y aplicaciones externas dentro de una interfaz más amplia. Un empleado senior de OpenAI habría descrito el formato clásico del chat como muerto. La frase suena dramática, pero apunta a algo práctico. OpenAI construyó una de las interfaces más reconocibles de internet, y ahora necesita que ese hábito produzca ingresos más estables mientras avanza hacia una salida a bolsa.
La caja actual de ChatGPT es fácil de entender. Una persona escribe, el sistema responde y el intercambio se siente casi gratis aunque el coste de cómputo sea alto. Un ChatGPT rediseñado cambiaría esa rutina al colocar más acciones pagadas alrededor de la conversación. Una petición podría convertirse en una sesión de programación, un archivo generado, una reserva, un flujo ejecutado por un agente o una tarea completada mediante una aplicación asociada. El usuario quizá siga empezando con una frase, pero el producto puede llevar esa frase hacia servicios con precios, suscripciones, límites y comisiones. OpenAI pule la interfaz mientras intenta convertir ChatGPT de un hábito que la gente visita en un negocio por el que la gente paga.
Google Gemini has become the main global sponsor of the Argentine Football Association for the 2026 World Cup, WIRED reported on June 10. The agreement puts Gemini's name on Argentina's training kit and gives players and staff access to AI tools for play breakdowns, performance metrics, statistics, and opponent analysis. Google has not described the internal systems in detail, but the public side is clearer. During the tournament, Search will answer fan questions in real time, analyze key plays, supply deeper statistics, and help generate songs, memes, cartoons, and other match-day material for social platforms. The company has also reached deals with Brazil and France, but Argentina gives the project its most charged costume, a champion's shirt and the remaining aura of Lionel Messi.
Football has admitted machines before when they promised a narrower form of judgment. GPS measured training loads, VAR slowed down disputed goals, broadcast graphics converted movement into diagrams. Gemini enters through a wider door. Google places an assistant inside coaching work and beside the supporter, where memory, argument, insult, superstition, and statistics already mix during a match. The fan who once shouted at a television can now ask a phone for the correct number, the likely substitution, the usable meme, or the tactical explanation seconds after the whistle. Sponsorship usually rents visibility on cloth. This one tries to occupy the interval between the event and the sentence a spectator sends about it.
Google Gemini se convirtió en patrocinador global principal de la Asociación del Fútbol Argentino para el Mundial de 2026, informó WIRED el 10 de junio. El acuerdo coloca el nombre de Gemini en la ropa de entrenamiento de Argentina y da a jugadores y cuerpo técnico acceso a herramientas de IA para desglosar jugadas, revisar métricas de rendimiento, consultar estadísticas y estudiar rivales. Google no ha descrito esos sistemas internos en detalle, pero la cara pública es más visible. Durante el torneo, Search responderá preguntas de los fans en tiempo real, analizará jugadas clave, aportará estadísticas más profundas y ayudará a generar canciones, memes, caricaturas y otros materiales de partido para redes sociales. La compañía también cerró acuerdos con Brasil y Francia, aunque Argentina le ofrece al proyecto su disfraz más cargado, la camiseta del campeón y el resto del aura de Lionel Messi.
El fútbol ya había aceptado máquinas cuando prometían una forma más estrecha de juicio. El GPS midió cargas de entrenamiento, el VAR ralentizó goles discutidos, los gráficos de transmisión convirtieron movimiento en diagramas. Gemini entra por una puerta más amplia. Google coloca un asistente dentro del trabajo técnico y junto al hincha, donde memoria, discusión, insulto, superstición y estadística se mezclan durante un partido. Quien antes gritaba frente al televisor ahora puede pedirle al teléfono el número correcto, el cambio probable, el meme utilizable o la explicación táctica segundos después del silbato. El patrocinio suele alquilar visibilidad sobre una tela. Este intenta ocupar el intervalo entre el hecho y la frase que un espectador envía sobre ese hecho.
Jeff Bezos has backed Flourish, a neuro-AI startup trying to build artificial intelligence around the energy discipline of the human brain. According to Wired, the company has $500 million in funding, a reported $2.5 billion valuation, and a plan to study real neurons with advanced lab equipment while its engineers search for models that can learn continuously. The target is blunt. Flourish wants an artificial system that runs on 50 watts or less, close to the power budget of a person thinking, instead of the data-center hunger now attached to frontier AI. Its founders, Rob Williams and neuroscientist Thomas Reardon, argue that current language models consume vast power and data while remaining frozen after training.
The proposal returns AI to an older embarrassment. The industry borrowed the prestige of the brain, named its systems neural, then built machines that require warehouses, cooling plants, power contracts, and scraped archives to imitate a sentence. Flourish turns that mismatch into a business thesis. If the brain contains a usable computational trick, the next infrastructure race may pass through microscopes, connectomes, hippocampus research, chip negotiations, and patient venture money. The promise is elegant and suspicious in equal measure. A billionaire funds the search for biological thrift after the industry has made waste look inevitable. The laboratory bench now sits beside the server bill.
Jeff Bezos ha respaldado a Flourish, una startup de neuro-IA que intenta construir inteligencia artificial alrededor de la disciplina energética del cerebro humano. Según Wired, la compañía cuenta con 500 millones de dólares de financiación, una valoración reportada de 2.500 millones y un plan para estudiar neuronas reales con equipos avanzados de laboratorio mientras sus ingenieros buscan modelos capaces de aprender de forma continua. El objetivo es directo. Flourish quiere un sistema artificial que funcione con 50 vatios o menos, cerca del presupuesto energético de una persona pensando, en lugar del apetito de centros de datos que hoy acompaña a la IA de frontera. Sus fundadores, Rob Williams y el neurocientífico Thomas Reardon, sostienen que los modelos actuales consumen enormes cantidades de energía y datos mientras quedan congelados después del entrenamiento.
La propuesta devuelve la IA a una vergüenza antigua. La industria tomó prestado el prestigio del cerebro, llamó neuronales a sus sistemas y luego construyó máquinas que necesitan naves, plantas de enfriamiento, contratos eléctricos y archivos raspados para imitar una frase. Flourish convierte ese desajuste en tesis de negocio. Si el cerebro contiene un truco computacional aprovechable, la próxima carrera de infraestructura puede pasar por microscopios, conectomas, investigación del hipocampo, negociaciones con fabricantes de chips y capital paciente. La promesa resulta elegante y sospechosa en la misma medida. Un multimillonario financia la búsqueda de austeridad biológica después de que la industria hizo que el derroche pareciera inevitable. La mesa de laboratorio queda ahora junto a la factura del servidor.
Silicon Valley's AI boom has created a premium market for paid human attention around the men who build, finance, and profit from automated intelligence. According to Forbes, high-end companions now court clients in and around the industry with a mixture of sex, technical fluency, emotional availability, and cultural codes drawn from AI, crypto, longevity, biohacking, and rationalist circles. Meida Marek, a pseudonymous recent graduate who left an entry-level finance job after wondering when AI would do it better, now sells companionship to clients that include people from Nvidia. Others in the niche market themselves through X posts, interactive booking portals, programming backgrounds, or the promise of being attractive enough for desire and informed enough for a three-hour argument. Forbes cites rates from about $3,000 to $5,000 an hour, with some day or weekend arrangements climbing far higher.
The sharper fact sits in the new price of unautomated presence inside a culture that keeps trying to simulate it. AI companionship makes attention cheap, obedient, tireless, and available on demand. AI wealth gives certain clients the money to buy the opposite experience. A human companion can be bored, skeptical, amused, delayed, distracted, technically literate, physically present, and socially dangerous in ways a chatbot is trained to smooth away. The invoice buys intimacy, but it also buys resistance to total optimization. The men building synthetic conversation pay for a dinner where the other mind is expensive because it can still leave the room.
El boom de la IA en Silicon Valley ha creado un mercado premium de atención humana pagada alrededor de los hombres que construyen, financian y rentabilizan la inteligencia automatizada. Según Forbes, acompañantes de lujo cortejan ahora a clientes de esa industria con una mezcla de sexo, fluidez técnica, disponibilidad emocional y códigos culturales tomados de la IA, las criptomonedas, la longevidad, el biohacking y los círculos racionalistas. Meida Marek, seudónimo de una recién graduada que dejó un empleo inicial en finanzas tras preguntarse cuándo la IA lo haría mejor, vende hoy compañía a clientes que incluyen personas de Nvidia. Otras mujeres del nicho se promocionan con publicaciones en X, portales de reserva interactivos, pasado como programadoras o la promesa de ser suficientemente atractivas para el deseo y suficientemente informadas para una discusión de tres horas. Forbes cita tarifas de unos 3.000 a 5.000 dólares por hora, con acuerdos de día o fin de semana que suben mucho más.
El dato más afilado aparece en el nuevo precio de la presencia no automatizada dentro de una cultura que intenta simularla. La compañía artificial vuelve la atención barata, obediente, incansable y disponible bajo demanda. La riqueza de la IA da a ciertos clientes el dinero para comprar la experiencia opuesta. Una acompañante humana puede aburrirse, dudar, divertirse, retrasarse, distraerse, conocer el lenguaje técnico, estar físicamente presente y resultar socialmente peligrosa en formas que un chatbot aprende a suavizar. La factura compra intimidad, pero también compra resistencia a la optimización total. Los hombres que construyen conversación sintética pagan por una cena donde la otra mente resulta cara porque todavía puede salir de la habitación.
An international study led by researchers at the Universidad Politécnica de Madrid, with participation from King's College London, found that customized versions of ChatGPT often violate OpenAI's own usage rules. According to Agencia EFE, the team audited hundreds of public assistants and found at least one potentially noncompliant answer in 58.7 percent of cases. Romantic assistants were the most exposed category. Although OpenAI prohibits GPTs dedicated to fostering romantic companionship, 98 percent of those examined broke that rule, with some presenting themselves as virtual partners or answering in language designed to simulate sentimental attachment. Academic assistants also accepted requests to write full essays, solve assignments, or produce material ready to submit as a student's work. In cybersecurity, compliance was higher, but some bots still gave delicate technical instructions without establishing consent or legality.
The audit matters through its method. The researchers did not need to inspect the hidden configuration of each assistant. They asked questions, watched the answers, and measured the distance between published policy and actual behavior. That distance grew sharper when the same tests on base models, GPT-4 and GPT-4o, produced similar conduct in over 92 percent of comparable cases. Part of the failure arrives before customization. The store simply gives it costumes, names, categories, and a public route to users. A platform can remove reported assistants afterward, as OpenAI did in some cases, but the scale changes the burden of supervision. Every new romantic tutor, homework helper, or security coach becomes a small public experiment in enforcement, waiting for someone to ask the wrong useful question.
Un estudio internacional liderado por investigadores de la Universidad Politécnica de Madrid, con participación del King's College London, encontró que las versiones personalizadas de ChatGPT incumplen con frecuencia las propias normas de uso de OpenAI. Según Agencia EFE, el equipo auditó centenares de asistentes públicos y encontró al menos una respuesta potencialmente contraria a las políticas en el 58,7 por ciento de los casos. Los asistentes románticos fueron la categoría más expuesta. Aunque OpenAI prohíbe los GPTs dedicados a fomentar compañía sentimental, el 98 por ciento de los examinados rompió esa regla, con sistemas que se presentaban como pareja virtual o respondían con lenguaje diseñado para simular apego. Los asistentes académicos también aceptaban escribir ensayos completos, resolver tareas o producir material listo para entregar como trabajo del estudiante. En ciberseguridad hubo más cumplimiento, pero aparecieron bots que daban instrucciones técnicas delicadas sin aclarar consentimiento ni legalidad.
La auditoría pesa por su método. Los investigadores no necesitaron ver la configuración oculta de cada asistente. Hicieron preguntas, observaron respuestas y midieron la distancia entre la política publicada y la conducta real. Esa distancia se volvió más incómoda cuando las mismas pruebas sobre modelos base, GPT-4 y GPT-4o, produjeron comportamientos parecidos en más del 92 por ciento de los casos comparables. Parte de la falla llega antes de la personalización. La tienda solo le da disfraces, nombres, categorías y una ruta pública hacia los usuarios. Una plataforma puede retirar asistentes reportados después, como hizo OpenAI en algunos casos, pero la escala cambia la carga de supervisión. Cada nuevo tutor romántico, ayudante de tareas o consejero de seguridad se convierte en un experimento público de cumplimiento, esperando que alguien formule la pregunta útil equivocada.
OpenAI has begun rolling out Lockdown Mode for ChatGPT, an optional security setting meant for people and organizations handling sensitive data. The feature limits live browsing to cached content, prevents web image retrieval, disables deep research and agent mode, blocks Canvas networking, restricts file downloads, and changes how apps and connectors can reach outside services. The company presents the setting as protection against prompt injection, the class of attacks in which malicious instructions are hidden inside webpages, files, or connected sources. OpenAI also says the setting cannot guarantee safety. A hostile instruction may still appear in cached material or an uploaded file and distort a response.
The defensive gesture is unusually plain because it protects intelligence by subtracting action. The chat becomes safer when it stops browsing live pages, stops opening external paths, stops letting generated code touch the network, and stops behaving like an agent with errands to run. That admission cuts against the usual sales pitch of AI as frictionless access to every source, tool, app, calendar, image, and file. In a sensitive account, convenience itself becomes an attack surface. The user who turns on Lockdown Mode is accepting a smaller machine, one whose value depends on refusing some of the powers that made it attractive. The warning now sits in Settings under Security, beside the promise that a private question can travel through fewer exits.
OpenAI empezó a desplegar Lockdown Mode para ChatGPT, una configuración opcional de seguridad pensada para personas y organizaciones que manejan datos sensibles. La función limita la navegación en vivo a contenido en caché, impide recuperar imágenes desde la web, desactiva deep research y agent mode, bloquea la red en Canvas, restringe descargas de archivos y modifica la forma en que apps y conectores alcanzan servicios externos. La compañía presenta el ajuste como una protección contra la inyección de prompts, el tipo de ataque en el que instrucciones maliciosas quedan escondidas dentro de páginas, archivos o fuentes conectadas. OpenAI también advierte que el ajuste no garantiza seguridad absoluta. Una instrucción hostil puede aparecer en material en caché o en un archivo subido y alterar una respuesta.
El gesto defensivo resulta inusualmente claro porque protege la inteligencia restando acción. El chat se vuelve más seguro cuando deja de recorrer páginas en vivo, deja de abrir rutas externas, deja de permitir que el código generado toque la red y deja de comportarse como un agente con encargos pendientes. Esa admisión golpea la promesa habitual de la IA como acceso sin fricción a toda fuente, herramienta, app, calendario, imagen y archivo. En una cuenta sensible, la comodidad se convierte en superficie de ataque. Quien activa Lockdown Mode acepta una máquina más pequeña, cuyo valor depende de rechazar parte de las facultades que la hicieron atractiva. La advertencia queda ahora en Settings, bajo Security, junto a la promesa de que una pregunta privada puede viajar por menos salidas.
Sriram Krishnan will leave his post as senior White House policy adviser for artificial intelligence at the end of June, according to The Washington Post. His next move is expected to be an outside institution that keeps him close to the same policy field. The departure follows a period in which the Trump administration has treated AI as a matter of national industrial power, from data centers and energy supply to voluntary federal testing of powerful models. Krishnan, a former Andreessen Horowitz partner and veteran of several major technology companies, helped shape that agenda alongside David Sacks and other Silicon Valley figures brought into the orbit of government.
The important movement is institutional. Moving an adviser into an outside policy shop gives AI governance a flexible address, one able to speak the language of state strategy while remaining nearer to engineers, investors, and founders. The public office loses a name, but the network around the office keeps its channels open. When Trump speaks of taking public stakes in major AI companies, and when agencies ask developers to submit frontier models for cybersecurity review, the boundary between regulation and partnership becomes harder to read. Authority spreads through meetings, advisory councils, private institutes, executive orders, power contracts, and voluntary submissions. The next AI policy fight may arrive with a White House seal, a venture-capital accent, or a calendar invitation from an institution whose funding the public has to look up.
Sriram Krishnan dejará a finales de junio su cargo como asesor senior de política de inteligencia artificial en la Casa Blanca, según The Washington Post. Su próximo movimiento apunta a una institución externa que lo mantendría cerca del mismo campo político. La salida llega después de un período en el que la administración Trump ha tratado la IA como asunto de poder industrial nacional, desde centros de datos y suministro energético hasta pruebas federales voluntarias para modelos avanzados. Krishnan, exsocio de Andreessen Horowitz y veterano de varias grandes compañías tecnológicas, ayudó a moldear esa agenda junto a David Sacks y otras figuras de Silicon Valley incorporadas a la órbita del gobierno.
El desplazamiento importante es institucional. Mover a un asesor hacia una organización externa le da a la gobernanza de la IA una dirección flexible, capaz de hablar el idioma de la estrategia estatal mientras permanece más cerca de ingenieros, inversores y fundadores. La oficina pública pierde un nombre, pero la red que rodea a esa oficina conserva sus canales abiertos. Cuando Trump habla de tomar participaciones públicas en grandes compañías de IA, y cuando las agencias piden a los desarrolladores que sometan modelos frontera a revisión de ciberseguridad, la frontera entre regulación y asociación se vuelve más difícil de leer. La autoridad se reparte entre reuniones, consejos asesores, institutos privados, órdenes ejecutivas, contratos eléctricos y entregas voluntarias. La próxima disputa sobre política de IA puede llegar con sello de la Casa Blanca, acento de capital de riesgo o una invitación de calendario enviada por una institución cuyo financiamiento el público tendrá que buscar.
Quilty markets to the Hollywood industry an estimate for a film that does not yet exist. The company, created by producers Simon Horsman and Daniel Wood, says its artificial intelligence chain can analyze a script without the need to shoot it and issue a score from 0 to 100, covering narrative quality, commercial viability, audience resonance, and estimated budget, according to The Verge. The screenwriter uploads the text, pays for the study, and receives a dossier generated by models such as Claude, ChatGPT, Gemini, DeepSeek, and several sentiment-analysis tools. The intention is to speed up the meeting where authorization is granted, an environment where writers, producers, buyers, financiers, and executives already discuss the vocabulary of risk.
That meeting is the moment when the harm becomes tangible. An assessment does not have to be exact to divert the trajectory of a script in progress. It can turn a risky project into a fiscally imprudent proposal, make a conventional idea appear safer, or provide a producer with a spreadsheet-shaped justification for perpetuating an old bias. The cases cited by Quilty show the fragility of the agreement, since its algorithm reportedly favored Christy, which later registered a box office failure, over Sinners, a film that reached major success. The mistake is revealing because it exposes the illusion of predicting culture through management software. When public preference is incorporated into the financial file as a metric, the audience is projected before acquiring a ticket, behaving in a certain way in the theater, or transforming an unconventional cinematic work into a profitable one.
Quilty comercializa a la industria hollywoodense una estimación para un film que aún no existe. La compañía, creada por los productores Simon Horsman y Daniel Wood, asegura que su cadena de inteligencia artificial es capaz de analizar un guion sin necesidad de rodarlo y de emitir una puntuación que va de 0 a 100, abarcando la calidad narrativa, la viabilidad comercial, la resonancia con la audiencia y el presupuesto estimado, según The Verge. El guionista carga el texto, abona por el estudio y obtiene un dossier generado por modelos como Claude, ChatGPT, Gemini, DeepSeek y diversas herramientas de análisis de sentimiento. La intención es agilizar la junta en la que se otorga la autorización, un entorno donde escritores, productores, compradores, financiadores y ejecutivos ya discuten el vocabulario del riesgo.
Esa junta constituye el momento en que el perjuicio se vuelve tangible. Una valoración no tiene que ser exacta para desviar la trayectoria de un guion en proceso; puede convertir un proyecto arriesgado en una propuesta fiscalmente imprudente, hacer que una idea convencional parezca más segura, o proporcionar a un productor una justificación en forma de hoja de cálculo para perpetuar un sesgo histórico. Los casos citados por Quilty evidencian la fragilidad del acuerdo, pues su algoritmo habría privilegiado a Christy, que luego registró un fracaso de taquilla, frente a Sinners, película que alcanzó un gran éxito. El desacierto resulta revelador al exponer la ilusión de predecir la cultura mediante software de gestión. Cuando la preferencia del público se incorpora al expediente financiero como métrica, la audiencia queda proyectada antes de adquirir un boleto, de comportarse de cierta manera en la sala o de transformar en rentable una obra cinematográfica poco convencional.
A new critique of Centaur, the language model presented in 2025 as a system able to predict and simulate human behavior, cuts into one of AI's favorite borrowed costumes. The original Nature study reported that Centaur could anticipate decisions across psychological experiments with striking accuracy after training on over 10 million human choices from 160 studies and 60,000 people. A later paper in National Science Open argues that the performance may have come from overfitting. The model learned statistical shortcuts inside the training material instead of acquiring a working grasp of human decision-making.
The test was disarmingly plain. Researchers Nai Ding and Wei Liu modified multiple-choice prompts with an instruction asking Centaur to choose option A. A system following the task should obey that instruction across the altered questions. Centaur kept selecting the previously correct answers, as if the pattern in the exam outweighed the new command. That result does not settle the whole debate over machine reasoning, but it changes the burden of proof. Accuracy can no longer stand alone as evidence of thought. A model may reproduce the contour of human choice while missing the operation that gives a choice its meaning. The machine passes through the answer sheet and leaves the question almost untouched.
Una nueva crítica al modelo de lenguaje Centaur, presentado en 2025 como un sistema capaz de predecir y simular la conducta humana, apunta a uno de los disfraces favoritos de la inteligencia artificial. El estudio original publicado en Nature informó que Centaur podía anticipar decisiones en experimentos psicológicos con una precisión notable tras ser entrenado con más de 10 millones de elecciones humanas, extraídas de 160 estudios y 60.000 personas. Un artículo posterior en National Science Open sostiene que ese rendimiento pudo deberse a sobreajuste. El modelo aprendió atajos estadísticos dentro del material de entrenamiento y no desarrolló una comprensión operativa de cómo los humanos toman decisiones.
La prueba fue desarmantemente simple. Los investigadores Nai Ding y Wei Liu modificaron preguntas de opción múltiple añadiendo una instrucción que pedía a Centaur elegir la opción A. Un sistema que cumpliera la tarea debería obedecer esa indicación en las preguntas alteradas. Centaur siguió seleccionando las respuestas antes correctas, como si el patrón del examen pesara más que la nueva orden. Ese resultado no cierra el debate sobre el razonamiento de las máquinas, pero cambia la carga de la prueba, porque la precisión ya no puede sostenerse sola como evidencia de pensamiento. Un modelo puede reproducir el contorno de una elección humana sin captar la operación que le da sentido a elegir.
Amazon will begin showing AI-generated product images inside its shopping app when users search for items they cannot name precisely, TechCrunch reported on June 3. A query such as blue gingham dress may produce synthetic visual options under autocomplete suggestions, with variations in sleeve, length, or shape. Clicking one sends the shopper toward real listings through Amazon's visual search system. The company says the feature helps people translate vague desire into useful results. The awkward part is that the image itself may not correspond to an available product. A retailer full of real photographs is inserting fabricated ones at the threshold of purchase.
The mechanism changes the first moment of shopping. Before the user reaches a listing, a generated picture gives desire a visible form and trains the search around that form. The shopper is invited to choose a possible object, then accept the nearest available substitute. That can help when language fails, but it also moves the store from catalog to prompt. The synthetic image becomes a guide, a filter, and a small disappointment waiting to happen. A customer may click on an object that never existed, then compare real merchandise to the invented thing that taught them what to want.
Amazon empezará a mostrar imágenes de productos generadas por IA dentro de su app de compras cuando los usuarios busquen objetos que no pueden nombrar con precisión, informó TechCrunch el 3 de junio. Una consulta como vestido azul de cuadros puede producir opciones visuales sintéticas bajo las sugerencias de autocompletado, con variaciones de manga, largo o forma. Al tocar una, el comprador es enviado hacia listados reales mediante el sistema de búsqueda visual de Amazon. La compañía dice que la función ayuda a traducir un deseo impreciso en resultados útiles. La parte incómoda es que la imagen puede no corresponder a un producto disponible. Un minorista lleno de fotografías reales está insertando imágenes fabricadas en el umbral de la compra.
El mecanismo cambia el primer momento de la compra. Antes de que el usuario llegue a un listado, una imagen generada da forma visible al deseo y entrena la búsqueda alrededor de esa forma. El comprador queda invitado a elegir un objeto posible y luego aceptar el sustituto disponible más cercano. Eso puede ayudar cuando falla el lenguaje, pero también desplaza la tienda del catálogo al prompt. La imagen sintética se vuelve guía, filtro y pequeña decepción en espera. Un cliente puede tocar un objeto que nunca existió y después comparar la mercancía real con la cosa inventada que le enseñó qué querer.
Florida became the first U.S. state to sue OpenAI and Sam Altman over ChatGPT, accusing the company on June 1 of selling a dangerous product while presenting it as safe. Attorney General James Uthmeier's civil complaint says OpenAI ignored warnings, exposed minors to harm, collected data from children without adequate oversight, and built a system capable of encouraging dependency, self-harm, violence, and cognitive damage. The suit asks for civil penalties and court orders under unfair trade practice, product liability, public nuisance, and negligence claims. OpenAI says it has strengthened protections for minors, including age prediction, safer defaults, and parental tools.
The legal shift is precise. Florida is asking a court to treat the chatbot as a product whose design can be inspected, tested, and found defective. That means account linking, age checks, parental alerts, self-harm classifiers, usage logs, escalation rules, and marketing claims may become evidence rather than promises. The complaint also follows a state criminal inquiry into whether ChatGPT played a role before a Florida State University shooting. A private chat interface now faces the procedural grammar of discovery, subpoenas, expert reports, and damages. The disputed object is a window where a minor may type alone while the company, the parent, and the state argue afterward over who should have been notified.
Florida se convirtió en el primer estado de Estados Unidos en demandar a OpenAI y Sam Altman por ChatGPT, acusando a la empresa el 1 de junio de vender un producto peligroso mientras lo presentaba como seguro. La demanda civil del fiscal general James Uthmeier sostiene que OpenAI ignoró advertencias, expuso a menores a daños, recolectó datos de niños sin supervisión suficiente y construyó un sistema capaz de fomentar dependencia, autolesiones, violencia y daño cognitivo. La demanda pide sanciones civiles y órdenes judiciales por prácticas comerciales desleales, responsabilidad por producto, perjuicio público y negligencia. OpenAI afirma que reforzó las protecciones para menores, incluidas predicción de edad, configuraciones más seguras y herramientas parentales.
El giro legal es preciso. Florida pide a un tribunal tratar el chatbot como un producto cuyo diseño puede inspeccionarse, probarse y declararse defectuoso. Eso significa que vinculación de cuentas, controles de edad, avisos a padres, clasificadores de autolesión, registros de uso, reglas de escalamiento y promesas de marketing pueden convertirse en evidencia. La demanda también sigue a una investigación penal estatal sobre si ChatGPT tuvo un papel antes de un tiroteo en Florida State University. Una interfaz de chat privada enfrenta ahora la gramática procesal del descubrimiento de pruebas, las citaciones, los informes periciales y los daños. El objeto discutido es una ventana donde un menor puede escribir a solas mientras la empresa, los padres y el estado discuten después quién debió recibir aviso.
A genuine Monet painting became a test case for artificial suspicion after an X user posted it as if it had been generated by AI, Creative Bloq reported on May 23. The post asked viewers to explain what made the image inferior to a real Monet. Millions saw it, and many obliged. They found weak composition, empty texture, incoherent depth, poor color judgment, and a lack of human disorder. The evidence was confident and wrong. The image was an actual Monet.
The episode shows how quickly attribution can rearrange vision. Once the label says AI, the viewer begins looking for defects that confirm the label. Brushwork becomes artifact. Ambiguity becomes glitch. A strange passage of paint becomes proof of automation. The old work is judged from the accusation placed beside it before its surface has time to act. That matters for artists, museums, schools, and markets because the suspicion travels faster than provenance. Generative systems have made fake images easier to produce, and real images easier to mistrust. The false frame is the fraud. It teaches the public to see authenticity as an error waiting to be exposed.
Una pintura auténtica de Monet se convirtió en prueba de sospecha artificial después de que un usuario de X la publicara como si hubiera sido generada por IA, informó Creative Bloq el 23 de mayo. La publicación pedía al público explicar qué hacía que la imagen fuera inferior a un Monet real. Millones la vieron, y muchos respondieron. Encontraron composición débil, textura vacía, profundidad incoherente, mal juicio cromático y falta de desorden humano. La evidencia sonaba segura y estaba equivocada. La imagen era un Monet verdadero.
El episodio muestra la rapidez con que una atribución puede reorganizar la mirada. Cuando la etiqueta dice IA, quien mira empieza a buscar defectos que confirmen la etiqueta. La pincelada se vuelve artefacto. La ambigüedad se vuelve fallo. Un pasaje extraño de pintura se vuelve prueba de automatización. La obra antigua queda juzgada desde la acusación colocada a su lado antes de que su superficie tenga tiempo de actuar. Eso afecta a artistas, museos, escuelas y mercados porque la sospecha viaja más rápido que la procedencia. Los sistemas generativos han hecho más fácil producir imágenes falsas y desconfiar de imágenes reales. El marco falso es el fraude. Enseña al público a ver la autenticidad como un error pendiente de ser descubierto.